AI 帮你做完了,你学会了吗?
AI 能写代码、解释论文,也能很快做出一个可以运行的小工具。结果来得越容易,我们越会问:还需要花那么多时间学习吗?我更在意的是接下来的事:这一次做完了,下次遇到类似的问题,自己会不会更懂一点?
2023 年,CNBC 主持人 David Faber 在采访中问马斯克,AI 不断进步,该给即将进入职场的孩子什么建议?马斯克停顿了一会儿,承认这个问题很难回答,建议去做感兴趣、有成就感、对社会有用的事。这份职业上的不确定,也落在了学习上:今天投入的时间,以后还用得上吗?
最近在 SuperMuse 上读到 Simon Willison 的一篇短帖,他提起三篇影响过自己的博客,其中有 Joel Spolsky 在 2002 年写的《抽象泄漏定律》。我一直很喜欢 Joel 的文章,多年前读过这一篇,这次又翻了出来。
重读 Joel
Simon 说,这一篇 blog 让自己养成了一个习惯:主动了解工作所在层次之下的东西,以防某一天抽象发生泄漏。
所谓“抽象”,就是工具把复杂细节包起来,让我们用简单的方式做事。
比如,面向对象用对象和方法封装数据与行为,隐藏内部实现;关系数据库让我们通过表和查询管理数据,隐藏许多文件存储与磁盘读写的细节;对象关系映射(ORM)让我们通过程序里的对象操作数据库,处理对象与表之间的映射和常见 SQL 的生成。但被隐藏的细节仍可能影响结果。这种时候,抽象就“泄漏”了。
被藏起来的细节,会怎样回来?
一个表情,为什么长度不一定是 1?
做昵称输入框时,判断字符串长度似乎足够了。可 JavaScript 中 "😄".length 的结果是 2,因为它数的是 UTF-16 码元,并非人眼看到的字符。复杂的组合表情可能涉及更多码元。MDN 文档说明了这种区别。
遇到计数不对、截取后字符损坏的问题,就要往下理解编码和字符边界。一个“长度”属性,并没有替我们决定用户所说的“一个字”究竟是什么。
几行查询代码,为什么会让页面越来越慢?
许多框架允许我们像操作普通对象一样读取数据库。显示十本书及其作者,先取出书,再逐本读取作者,看起来很自然。但如果没有提前加载关联数据,背后可能是一次查书、十次查作者,总共十一次查询。这就是 N+1 查询问题。Rails 文档有具体的例子。
框架省下了手写 SQL 的工作,却没有取消查询的成本。页面慢下来时,需要看实际执行了什么、发出了多少次查询。只看表面那几行代码,可能找不到原因。
请求超时了,为什么不能直接再试一次?
假设程序发送了创建订单的请求,却迟迟没有收到结果。超时可能意味着服务器没有收到请求,也可能意味着订单已创建,只是响应没传回来。缺少防重复处理时,再发一次就可能多出一笔订单。
这时要理解客户端与服务器各自知道什么,以及怎样让同一次操作的重试只产生一次效果。Stripe 的幂等请求文档解释了其中一种做法。函数调用看起来很简单,通信的不确定性却仍然需要处理。
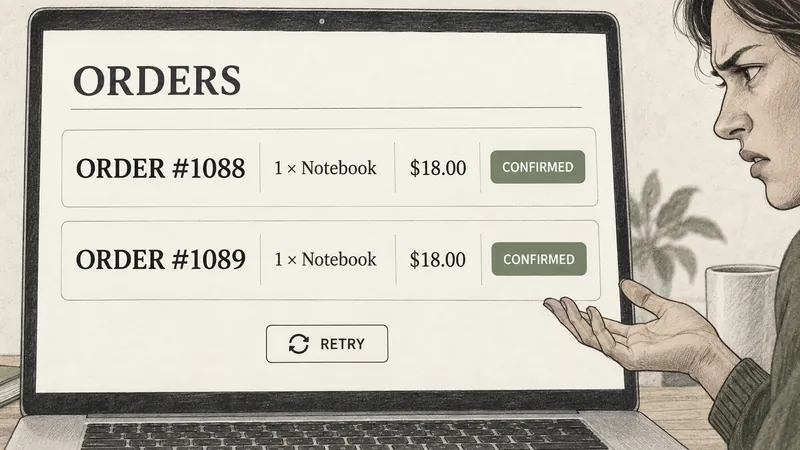
这些问题有一个共同点:想把事情真正弄清楚,往往还得往下面多看一层。
Joel 在文章中写道:
“So the abstractions save us time working, but they don’t save us time learning.”
抽象节省了工作的时间,却没有省去学习的时间。工具减少了重复劳动,但熟练调用一个接口,并不等于理解它背后的机制。
更高层的抽象,也会泄漏
从使用者的角度看,AI 编程把抽象又往上推了一层。我们可以用自然语言描述需求,让 AI 把它变成编程语言,再交给框架和系统执行。“做一个订单页面”这句话背后,可能已经包含了数据结构、查询方式和请求处理等一连串决定。
但更高层的抽象,仍然会泄漏。页面能打开,不代表数据增长后查询依然高效,也不代表并发提交时订单不会重复。这些细节一旦影响结果,就需要回到代码、数据库和通信机制中找原因。缺少对底层原理的理解和软件工程经验,往往连问题出在哪里、改动是否可靠,都难以判断。
在这个意义上,Joel 的抽象泄漏定律依然适用于 AI 编程。自然语言让我们更容易开始,系统运行的规则却仍在那里。理解底层,能让我们知道该怀疑什么,也知道怎样验证。
这一层抽象提高了生产力,却不会把理解也一并交付。工作变快,并不意味着学习会自动发生,也不意味着学习就变得容易、简单。 AI 可以解释原理、帮助设计实验,但把知识学扎实,仍需要自己推理、练习,并从反馈中修正判断。
答案正确,也可能没有学会
还有一种更难察觉的情况:AI 的答案完全正确,事情也顺利完成,自己却没有学到多少。
吴恩达在今年 8 月的一次访谈中谈到“认知卸载”:把一部分思考交给工具,也可能错过练习。他举了自己的例子:项目中遇到前后端组件的问题,问 AI、拿答案、做完;六个月后再碰到类似问题,却没有记住,只能再问。
这不能直接说成“AI 损伤了记忆力”。更准确的问题是:那些知识,可能从来没有被自己充分理解和记住。
一项发表于 PNAS 的研究,在土耳其一所高中对近千名学生开展数学学习实验。使用普通 GPT-4 对话工具的学生,有 AI 时练习表现提高;撤去 AI 后,独立考试成绩却比未使用 AI 的对照组低约 17%。另一种加入教师设计的提示、避免直接给答案的工具,大幅缓解了负面影响,但也没有让独立考试成绩显著超过对照组。
这不能代表所有学习场景,却提醒我们:完成任务的表现,和学习的结果,需要分开看。
看懂一个解释、照着答案做成功,很容易让人觉得自己已经会了。换一个条件,或者试着从头解释,才会发现哪里还不清楚。
杠杆的这一头
如今,人们常把 AI 比作一根杠杆。它让一个人有机会完成过去需要更多时间、更多人手才能做的事情。而杠杆这一头,是我们自己的积累。
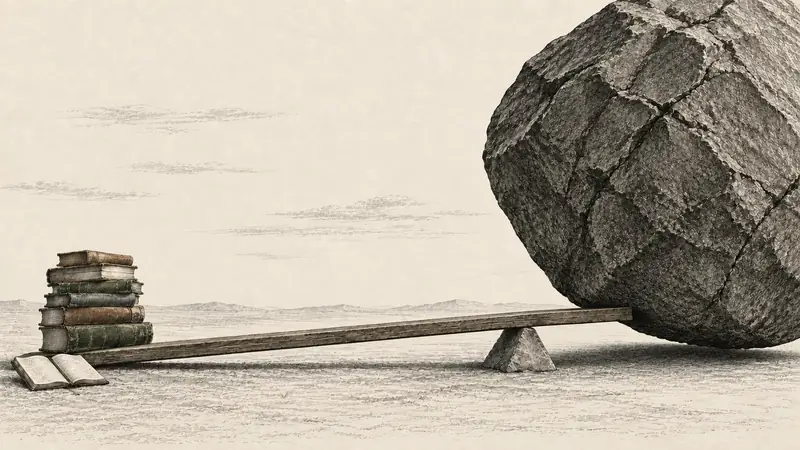
我们这一头的重量,是知识、经验,也是对眼前问题的了解。读文章时,能追问证据是否支持结论;做产品时,能分清用户的困难和自己想象的需求。有这些积累,和 AI 讨论时就更容易问到关键处,也更有机会把一个初步答案做成有用的东西。
积累多,不保证每次判断正确;新手也能借助 AI 做成以前做不了的事。自己的重量,可以边做边增加。 每次多弄懂一点,下一次能尝试的事情也就多一点。
避开苦修和全盘外包
强调学习,很容易走向“苦修”:觉得只有自己手写每一行代码,才算真正掌握。为了弄懂一次网络请求,不必先从头实现整套协议;工具省下的重复劳动,可以让我们把时间花在更值得理解的问题上。
另一个极端是全盘外包:把实现交给 AI,也把判断和验证一并交出去。结果能运行,就不再追问为什么;出了问题,只能继续让它重试。这样即使完成了很多任务,遇到抽象泄漏时,仍可能不知道从哪里查起。
我更愿意一边用,一边学。让 AI 帮忙完成工作,也给自己留下提问、验证和独立尝试的机会。需要多懂一些的地方,可以沿着眼前的问题逐步补上。
先看全貌,再深入细节
抽象泄漏提醒我们理解底层,但学习也要避免只见树叶、不见森林。先看清自己在解决什么问题、各个概念怎样联系,才知道哪些细节值得追下去。弄懂一个细节以后,也要回头看它在整体中处于什么位置。
AI 很适合帮助我们搭起这样的知识框架:梳理一个主题的核心概念,比较不同领域的相似问题,把新知识与已有经验联系起来。带着这张初步的地图,再去读原文、做实验,检查和修正其中的关系。留下的笔记,也可以记录自己的理解怎样改变。一次好的学习,应该给下一次思考留下东西。
和 Muse 一起读
在 SuperMuse 里,AI Muse 伴读可以陪你把这样的学习继续下去:带着原文讨论,在关键处用问题、反例,甚至一个容易踩进去的“坑”,请你先判断,再解释理由,看看哪里还没想清楚。
读完后,把新划线和旧笔记交给 Muse一起梳理,再由自己确认哪些联系说得通。我喜欢“温故而知新”:有了新问题,旧笔记也会多一层意思。阅读、记录和讨论接在一起,知识才有机会逐渐成为自己的理解。
AI 可以帮我们把事情做完。我希望它也能帮我们在做完之后,多懂一点。
参考与延伸阅读
- Simon Willison:What blog posts influenced your thinking the most?(2026-09-14)
- Joel Spolsky:The Law of Leaky Abstractions(2002-11-11)
- Will Larson:Migrations: the sole scalable fix to tech debt
- Charity Majors:The Engineer/Manager Pendulum
- CNBC:马斯克谈孩子的职业选择(2023-05-16);问答转录
- Silicon Valley Girl:Andrew Ng: The Biggest Opportunities in AI Aren’t Where You Think(2026-08-28,学习话题从 11:59 开始);访谈转录
- Bastani 等:Generative AI without guardrails can harm learning: Evidence from high school mathematics(PNAS,2025)
- Oracle:对象、封装与实现细节
- PostgreSQL:关系数据库的基本概念
- Rails:对象关系映射(ORM)
- Rails:N+1 查询问题
- Stripe:幂等请求
- MDN:字符串长度与 UTF-16 码元